트랜스포머 기반 모델의 구조
트랜스포머 기반 모델의 구조가 어떻게 발전해왔는지에 대해 다룬다.
Attention is All You Need
2017년 Attention is All You Need 논문을 통해 트랜스포머 구조가 처음 제안되어 널리 알려지게 되었다.
초기에 제안된 Attention과 FFN 조합은 대부분의 트랜스포머 변형 모델에서 유지되었으며, 이후 연구는 이를 보다 효과적으로 구현하기 위한 최적화에 초점을 맞추었다.
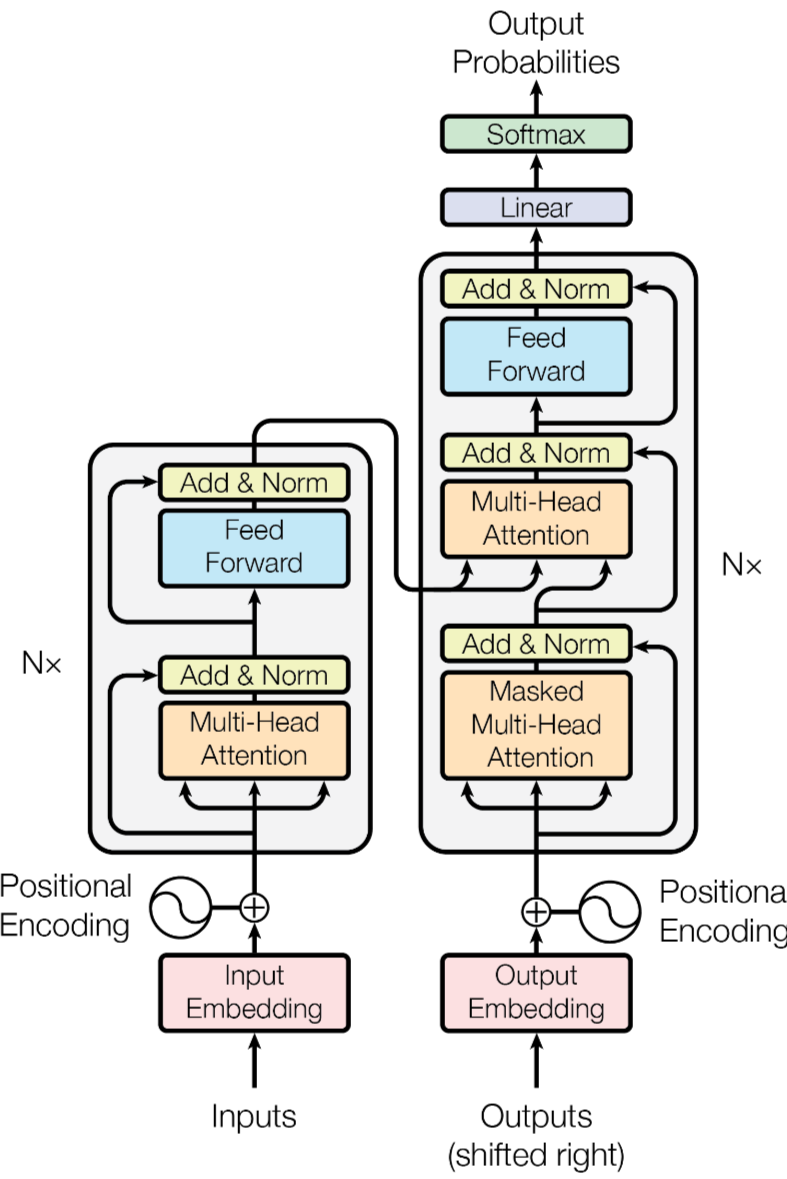
The Transformer - model architecture
트랜스포머는 입력을 해석하는 인코더 블록과 출력을 생성하는 디코더 블록으로 구성된다.
Attention
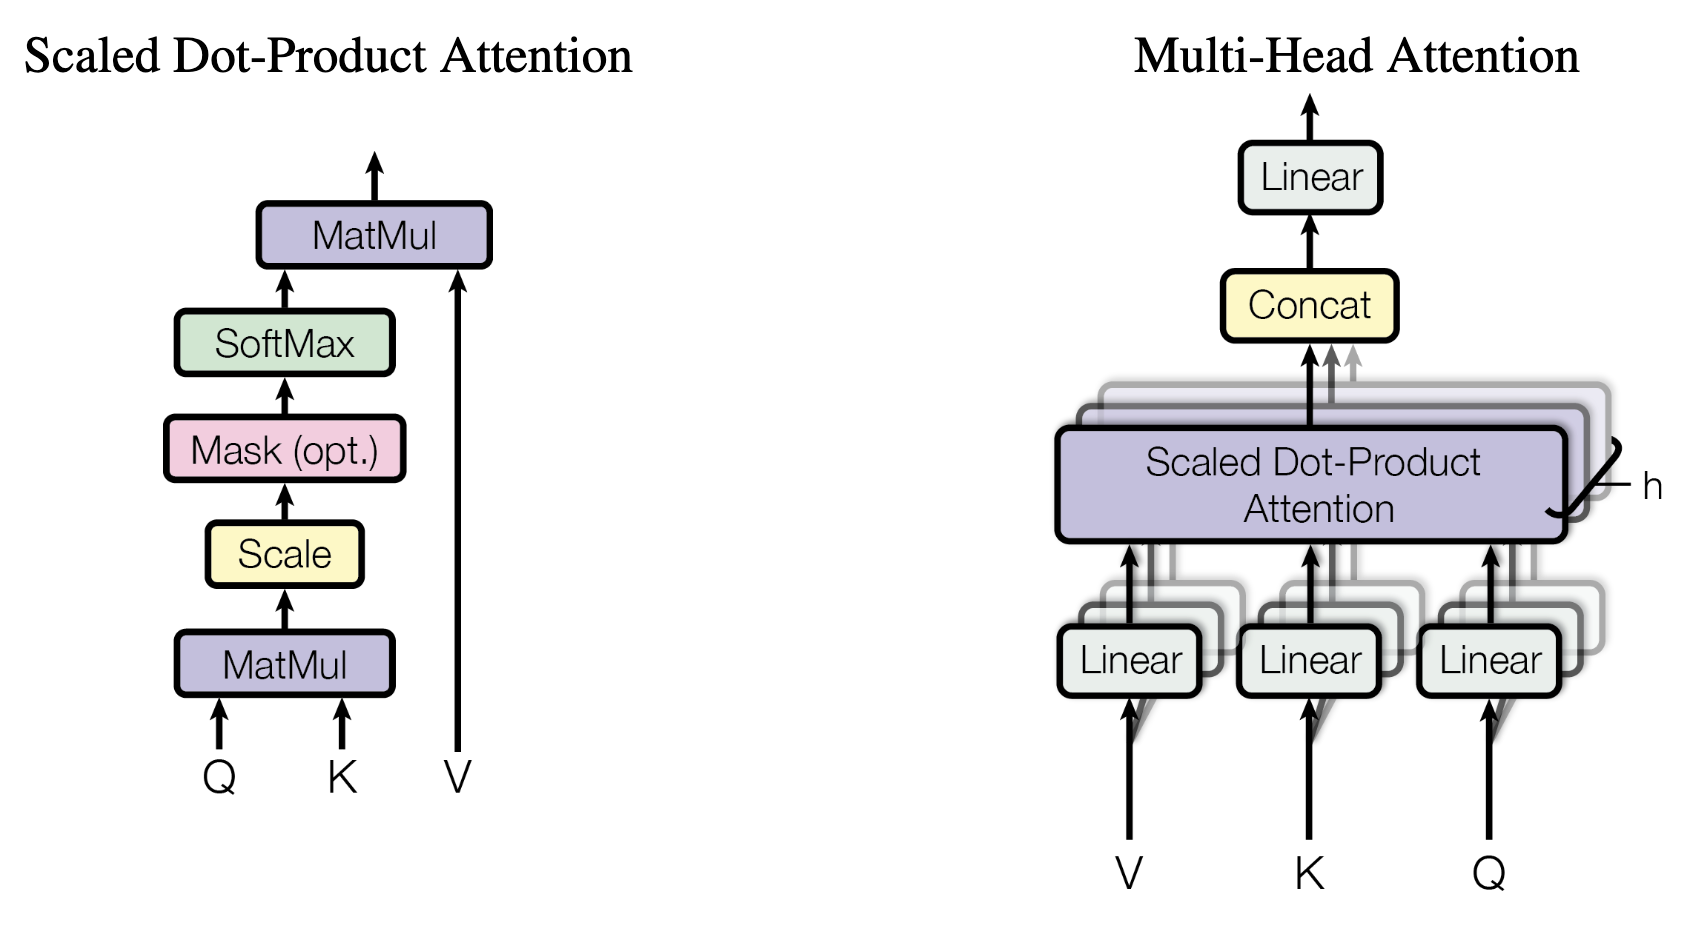
스케일드 닷 프로덕트 어텐션은 단어 간의 관련도를 점수로 계산해, 중요한 정보에 더 집중하게 한다.
멀티헤드 어텐션은 여러 어텐션을 동시에 사용해, 문장을 다양한 관점에서 이해할 수 있게 한다.
Feed Forward Network
FFN은 각 단어의 표현에 비선형 함수를 적용해, 표현력을 확장하는 역할을 한다.
\[\text{FFN}(x) = \max(0, xW_1 +b_1)W_2+b_2\]Improving Language Understanding by Generative Pre-Training
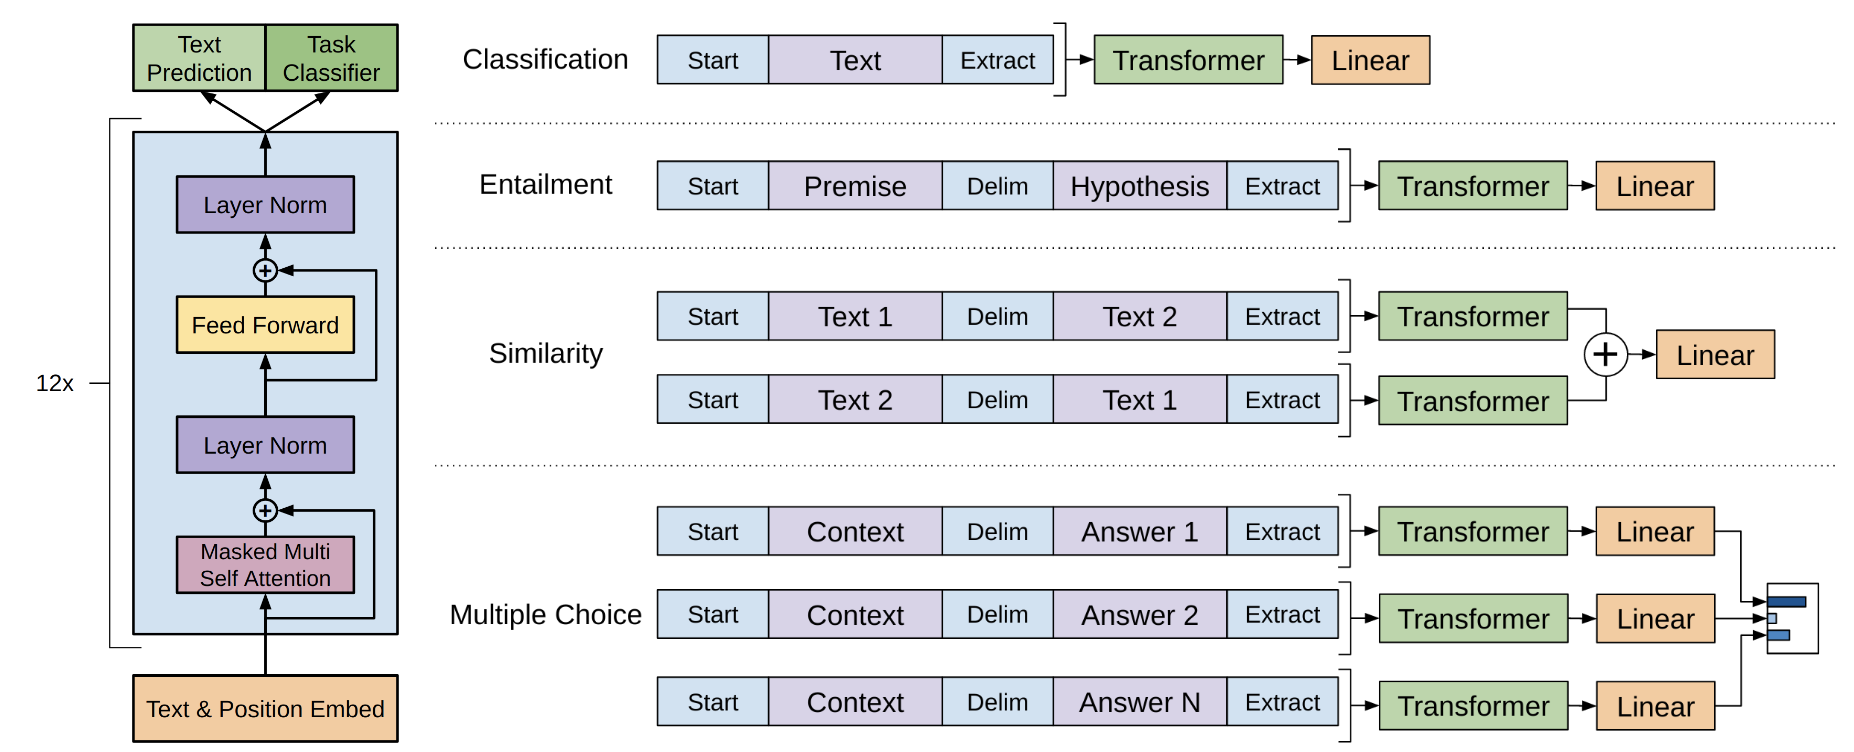
2018년 GPT-1 논문을 통해 알려졌다.
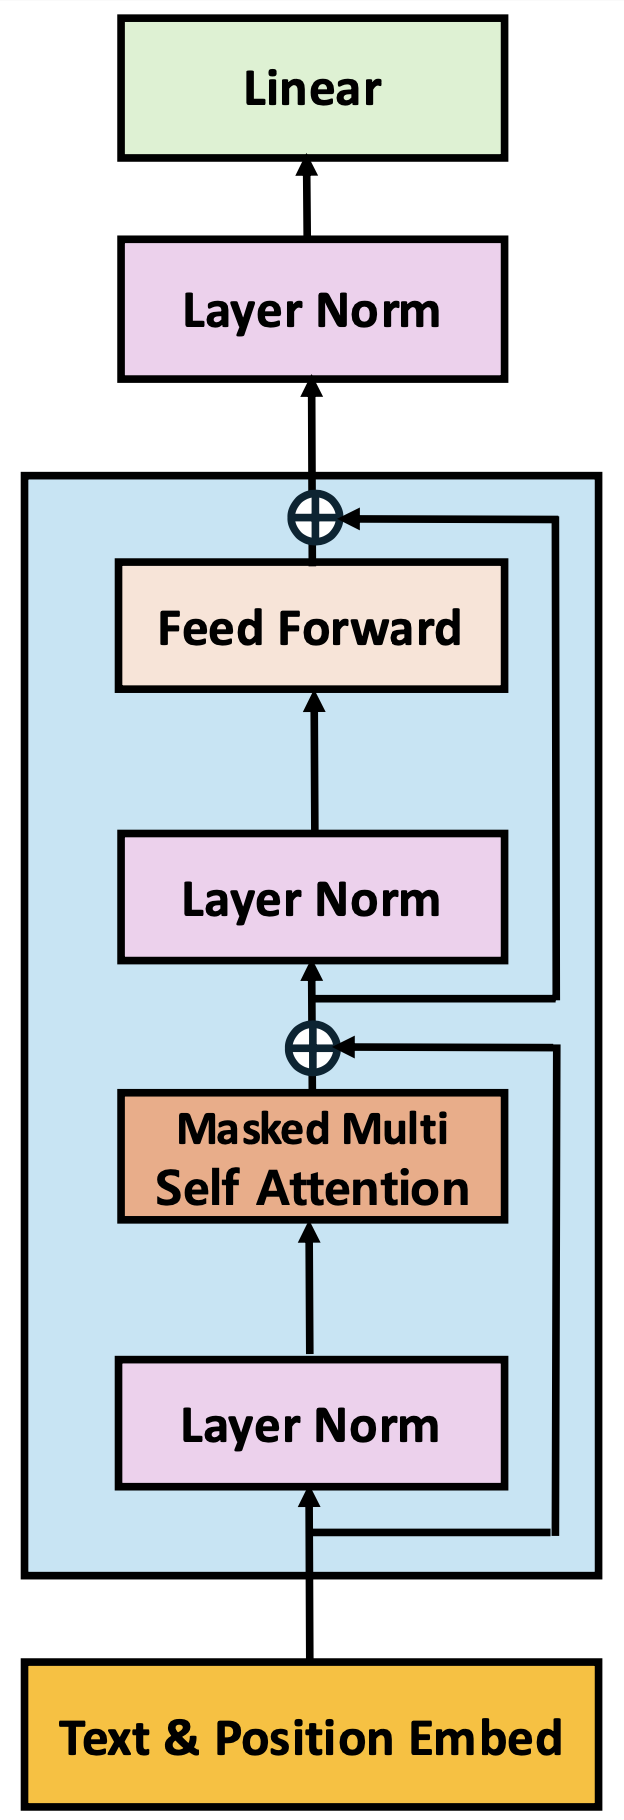
GPT-1은 Attention is All You Need 논문의 디코더 구조를 기반으로 하지만 Cross-Attention을 제거하고 causal self-attention만 사용한다.
BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding
2018년 BERT 논문을 통해 알려졌다.
BERT는 Attention is All You Need 논문의 인코더 구조를 기반으로 한다.
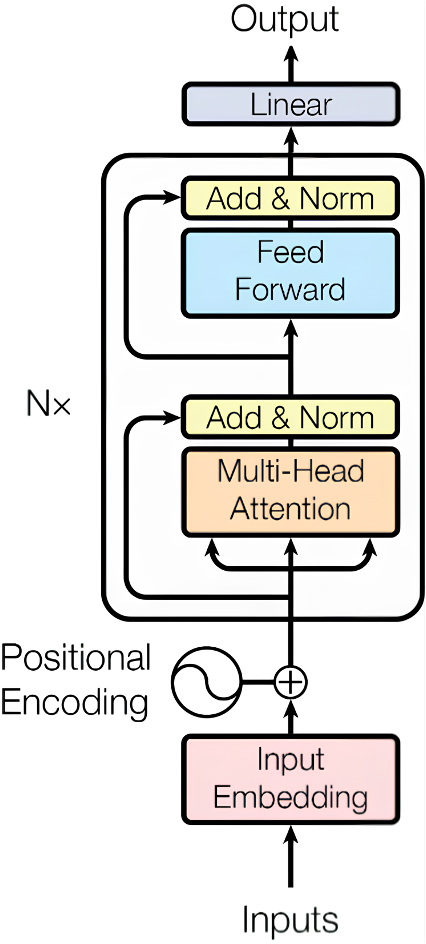
FFN의 비선형 함수로 ReLU 대신에 GeLU를 사용하고, 트랜스포머 블록 이후에 Norm이 한 번 더 추가되었다.
\[\text{FFN}(x) = \text{GELU}(0, xW_1 +b_1)W_2+b_2\]Language Models are Unsupervised Multitask Learners
2019년 GPT-2 논문을 통해 알려졌다.
GPT-2는 트랜스포머 블록에 Post-Norm 대신 Pre-Norm 을 적용하였고, 트랜스포머 블록 이후에 Norm이 한 번 더 추가되었다.
Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer
2019년 T5 논문을 통해 알려졌다.
Attention is All You Need 논문의 인코더-디코더 구조를 기반으로 한다.
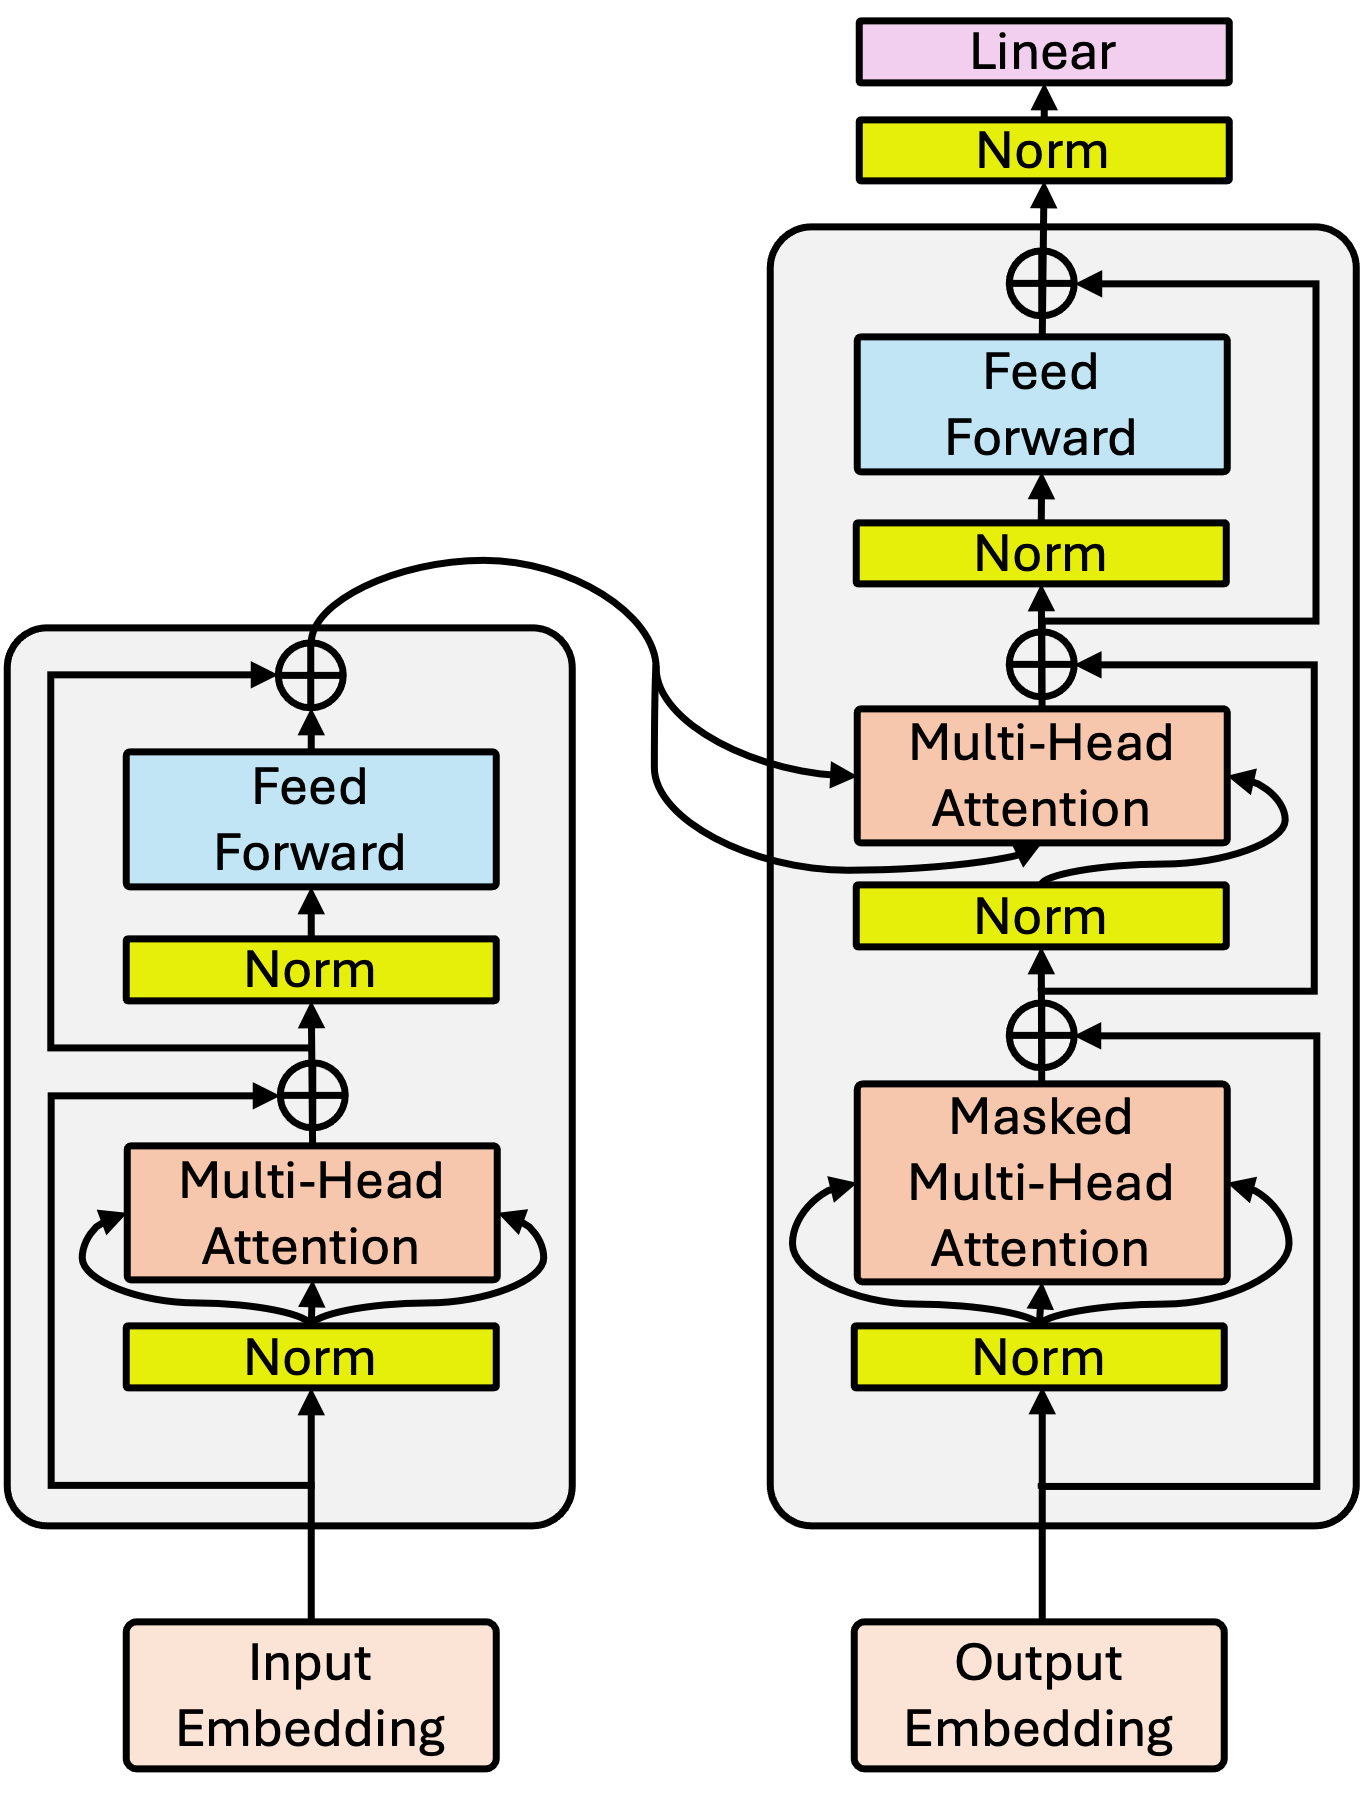
GPT-2와 같이 트랜스포머 블록에 Pre-Norm을 적용하였고, FFN의 비선형 함수로 ReLU를 사용하였다.
Absolute Positional Embedding이 아닌 Relative Position Encoding를 Relative Position Bias로 단순화하여 attention score에 적용하였다.
\[e_{ij} = \frac{(x_i W^Q)(x_j W^K)^T}{\sqrt{d_k}} + b_{i-j}\]An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale
2020년 ViT 논문을 통해 알려졌다.
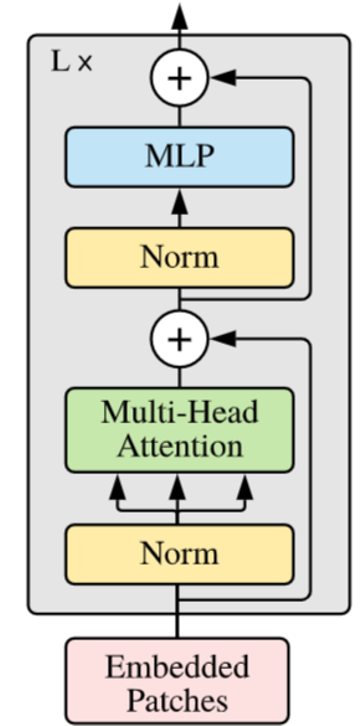
트랜스포머의 인코더 구조를 기반으로 하며, 이미지를 언어 모델에서 토큰을 처리하듯 임베딩 패치로 분할하여 입력으로 사용한다.
Llama 2: Open Foundation and Fine-Tuned Chat Models
2023년 Llama 2 논문을 통해 알려졌다.
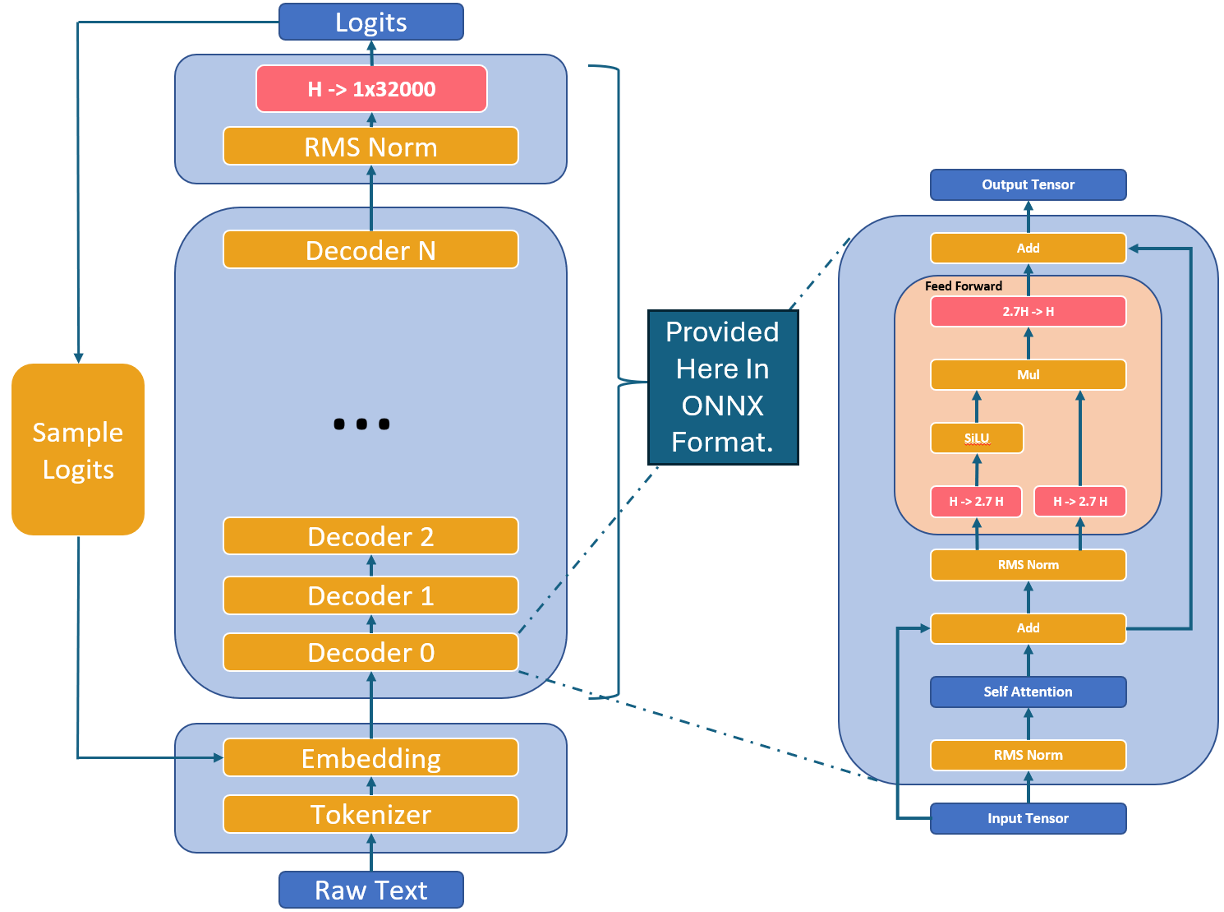
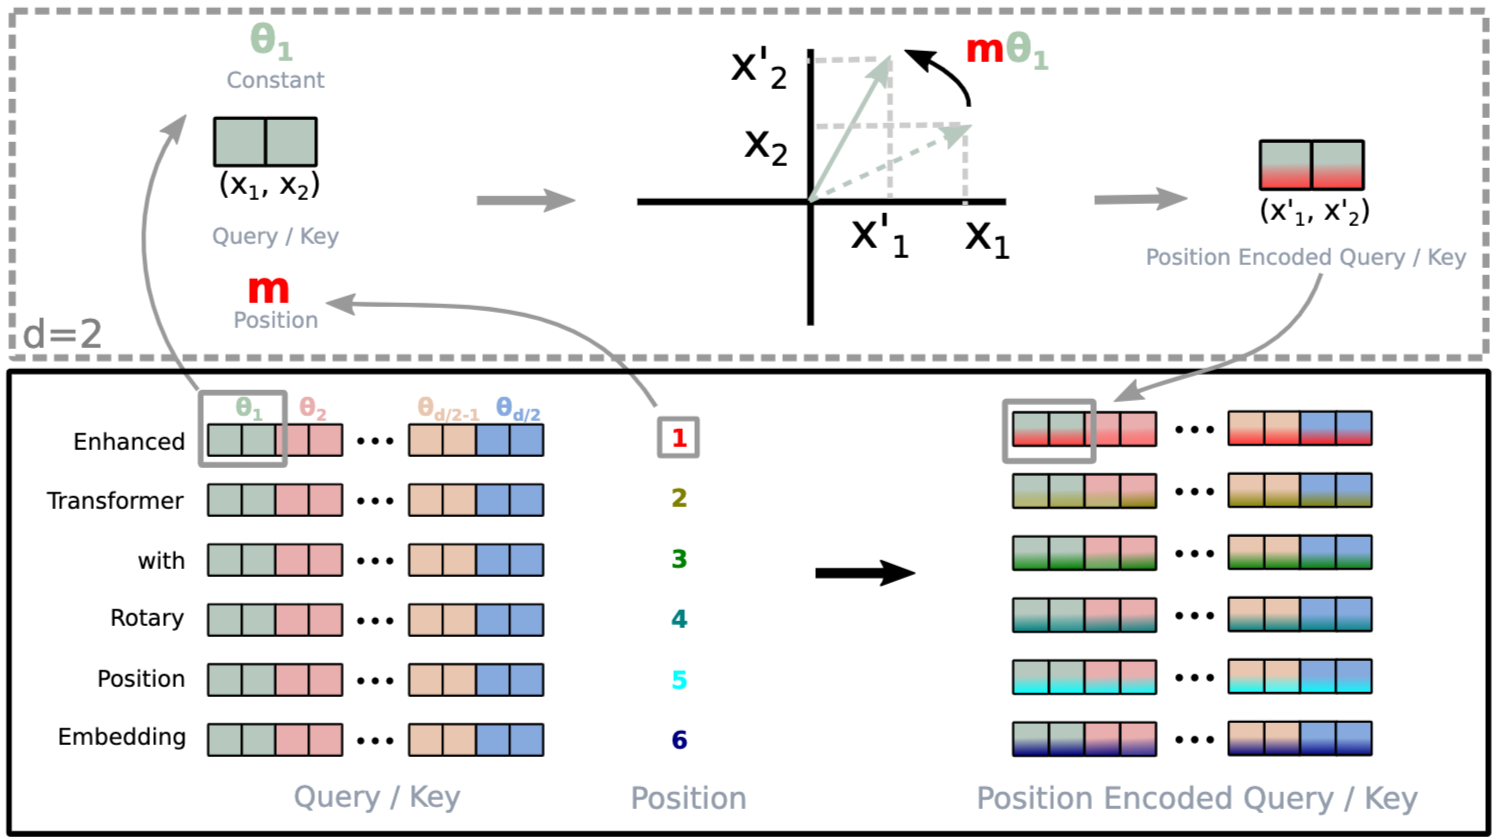
Attention
RoPE(Rotary Positional Embedding) 방식이 적용되었다.
- 학습하지 않는 방식이기 때문에, 시퀀스 길이가 달라져도 잘 일반화되는 특성을 갖는다.
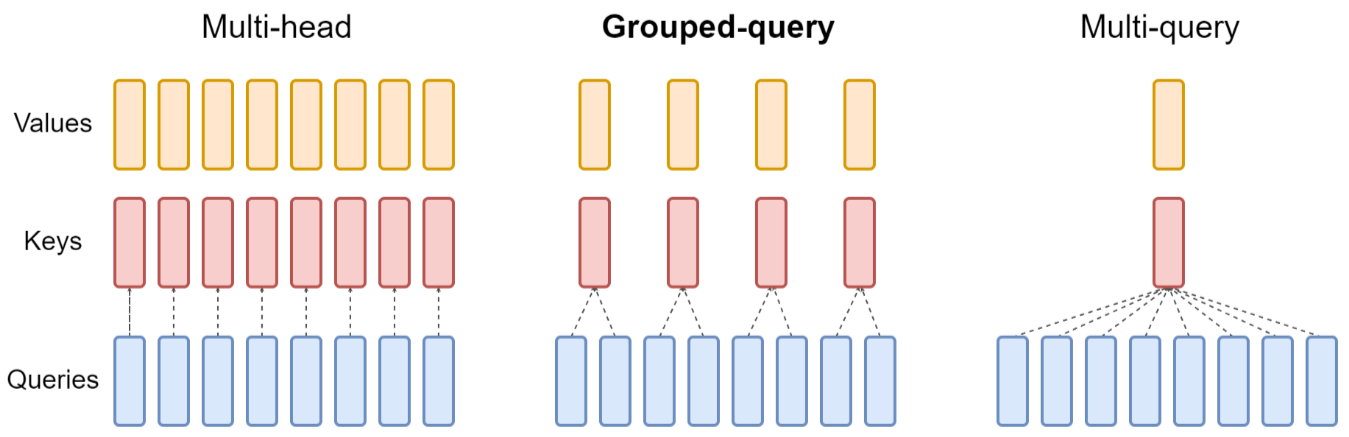
Llama 2-70B에는 GQA(Grouped Query Attention) 가 적용되었다.
- 각 토큰이 차지하는 KV cache 크기를 줄여 결과적으로 더 긴 문맥을 처리하기 위해서이다 .
Feed-Forward Network
\[\text{FFN}(x) = W_3 \cdot \left( \text{SiLU}(W_1 x) \odot (W_2 x) \right)\]Mistral 7B
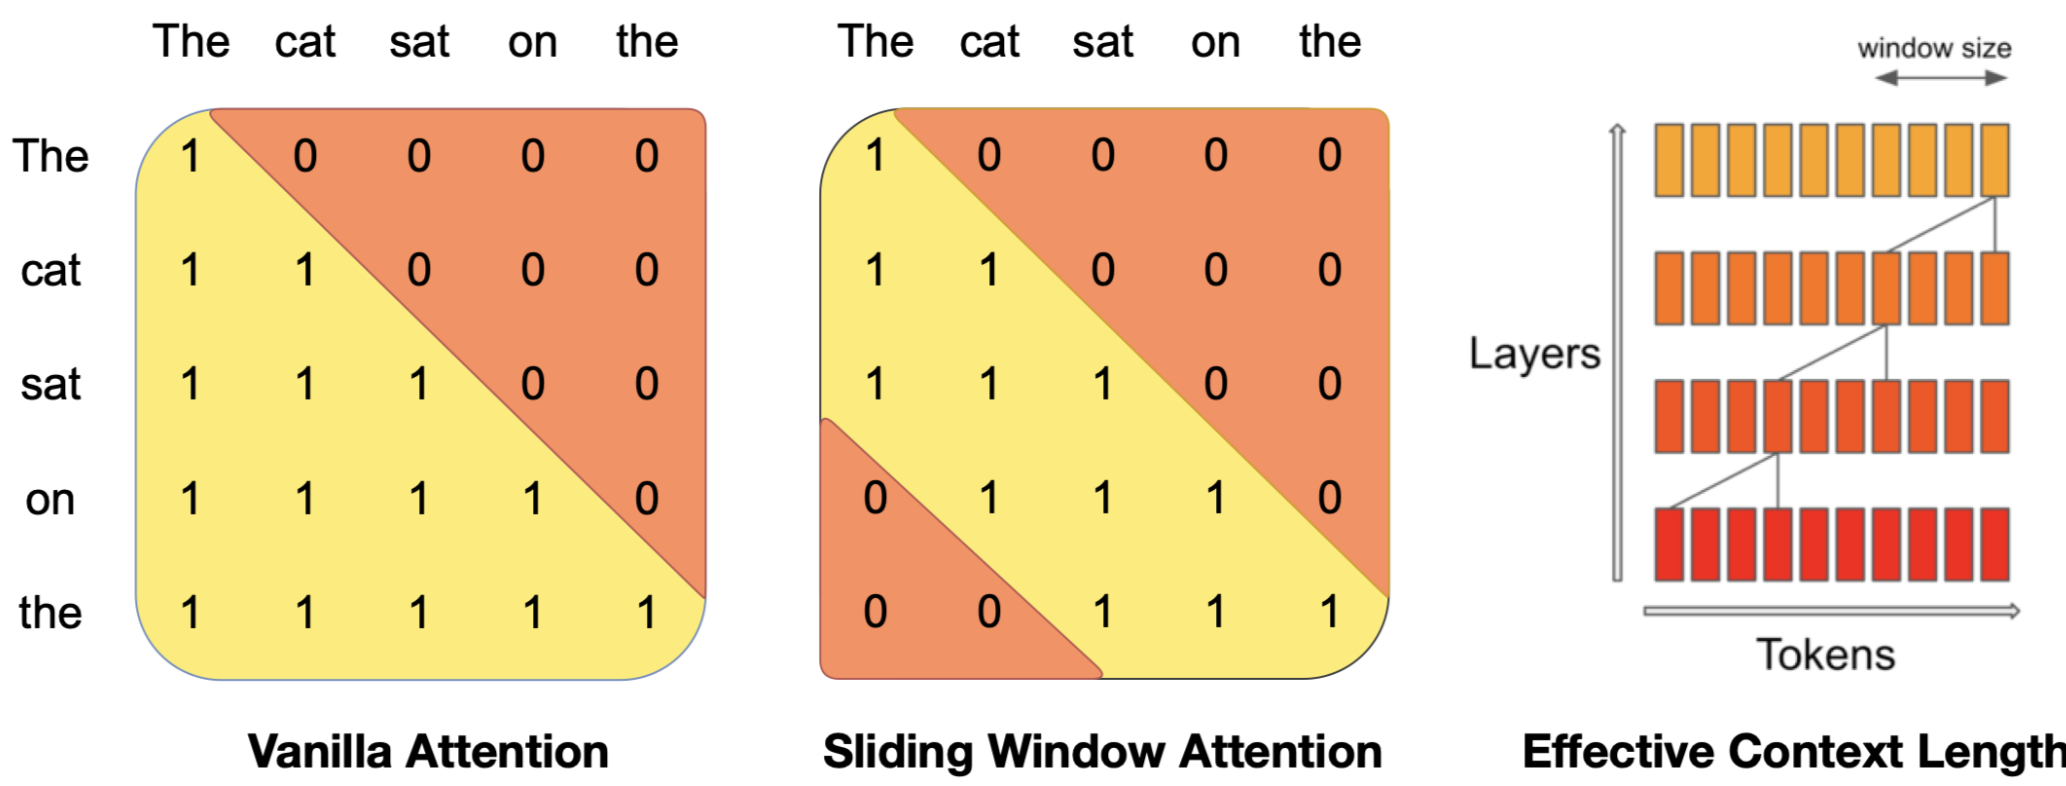
2023년 Mistral 논문을 통해 알려졌다.
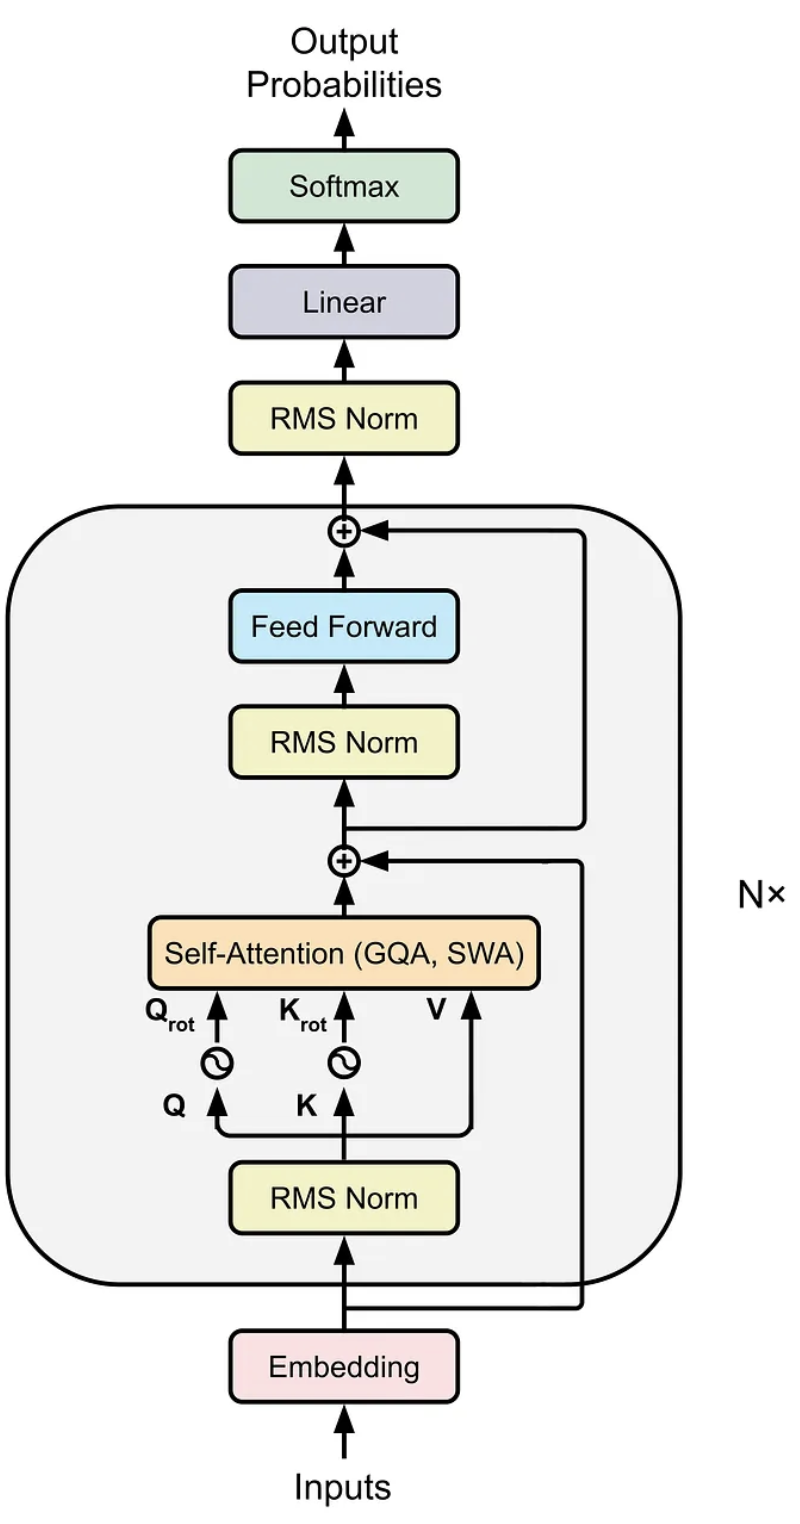
SWA (Slide Window Attention)
Gemma: Open Models Based on Gemini Research and Technology
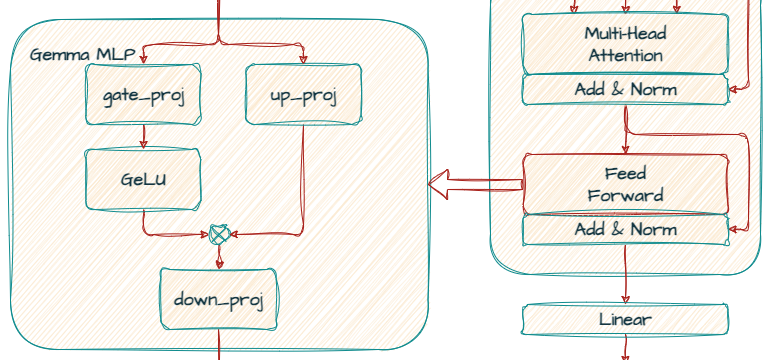
2024년 Gemma 논문을 통해 알려졌다.
Feed Forward Network
GEGLU를 사용한다.
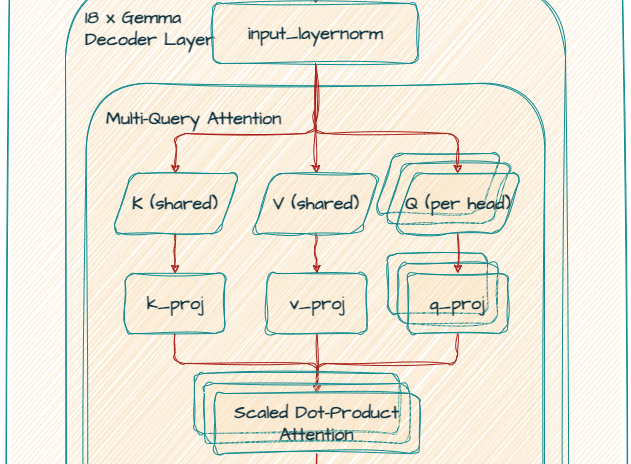
Attention
Gemma 2B모델은 MQA(Multi Query Attention)을 사용한다. 7B 모델은 다중 헤드 어텐션(MHA)을 사용한다.
Gemma 2: Improving Open Language Models at a Practical Size
2024년 Gemma 2 논문을 통해 알려졌다.
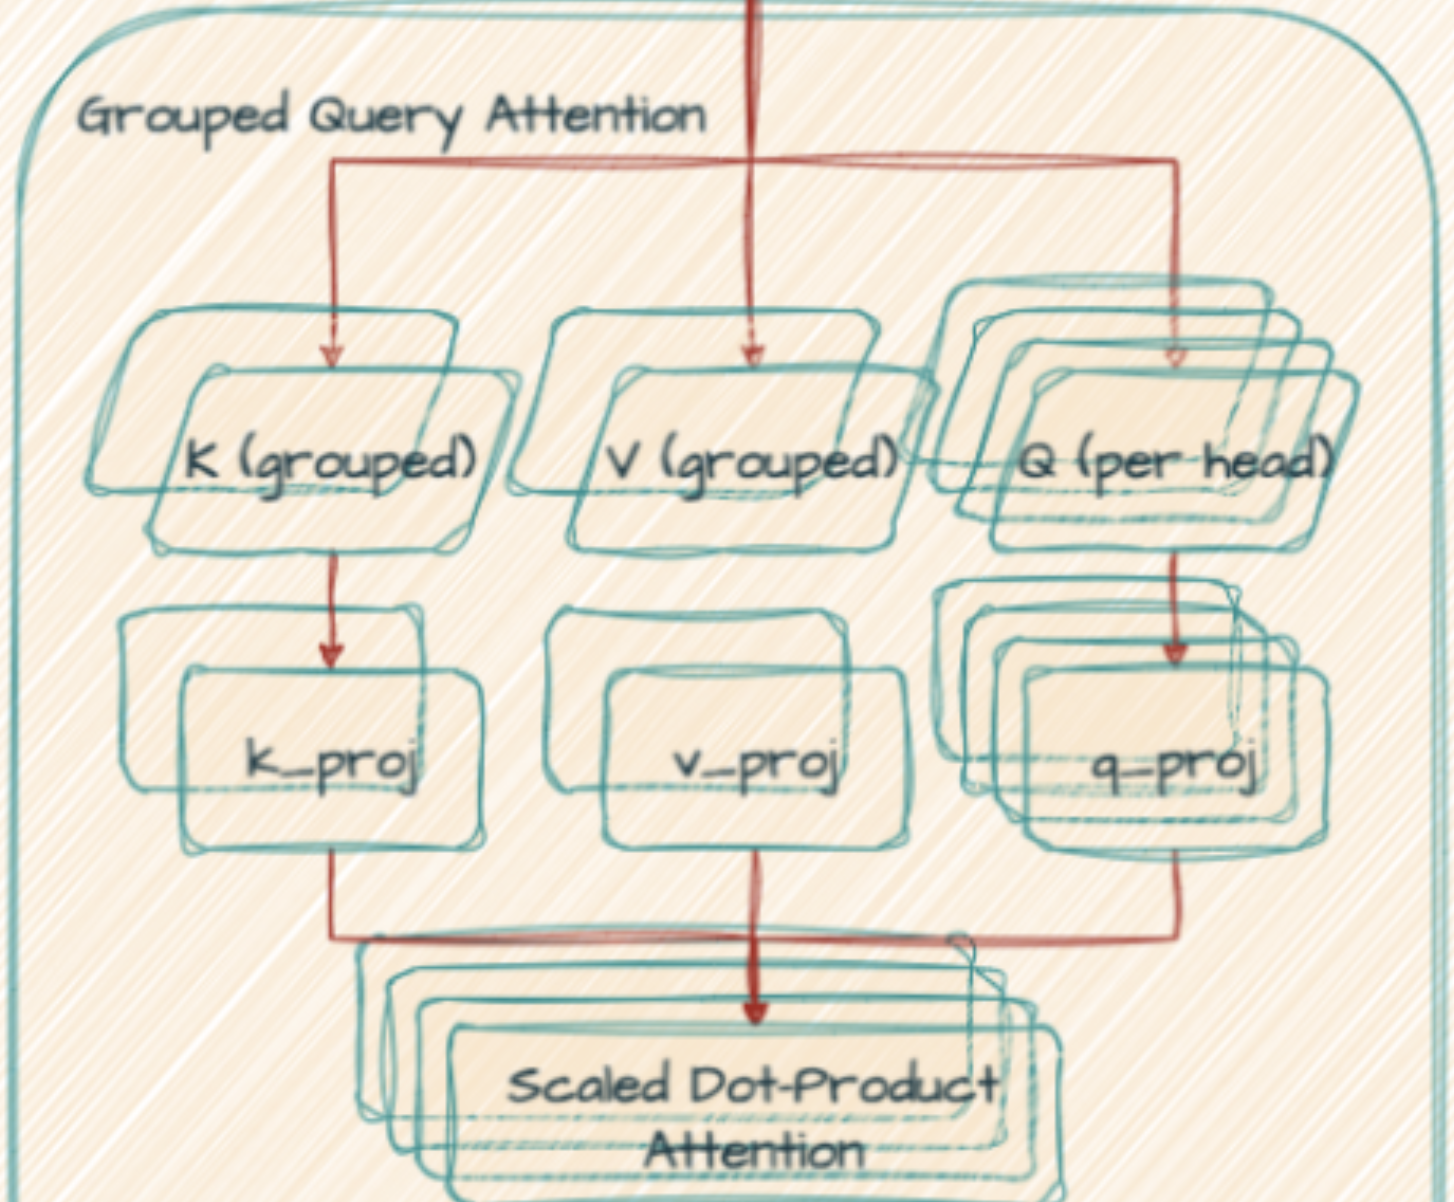
Attention
GQA(Group Query Attention)을 적용하였다.
DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning
2025년 DeepSeek-R1 논문을 통해 알려졌다.
