[논문 리뷰] LLM.int8()
LLM.int8()는 대규모 언어 모델(LLM)의 추론 과정을 가속화하고 메모리 사용량을 줄이기 위해, PTQ(Post-Training Quantization) 기반의 8비트(weight-only) 양자화를 적용하여 정확도 손실 없이 추론이 가능하도록 한 연구입니다.
LLM.int8()는 당시 워싱턴 대학교의 박사 과정 Tim Dettmers가 제1저자로 주도하였으며, 2022년 NeurIPS 2022에 발표되었습니다.
Schemetic
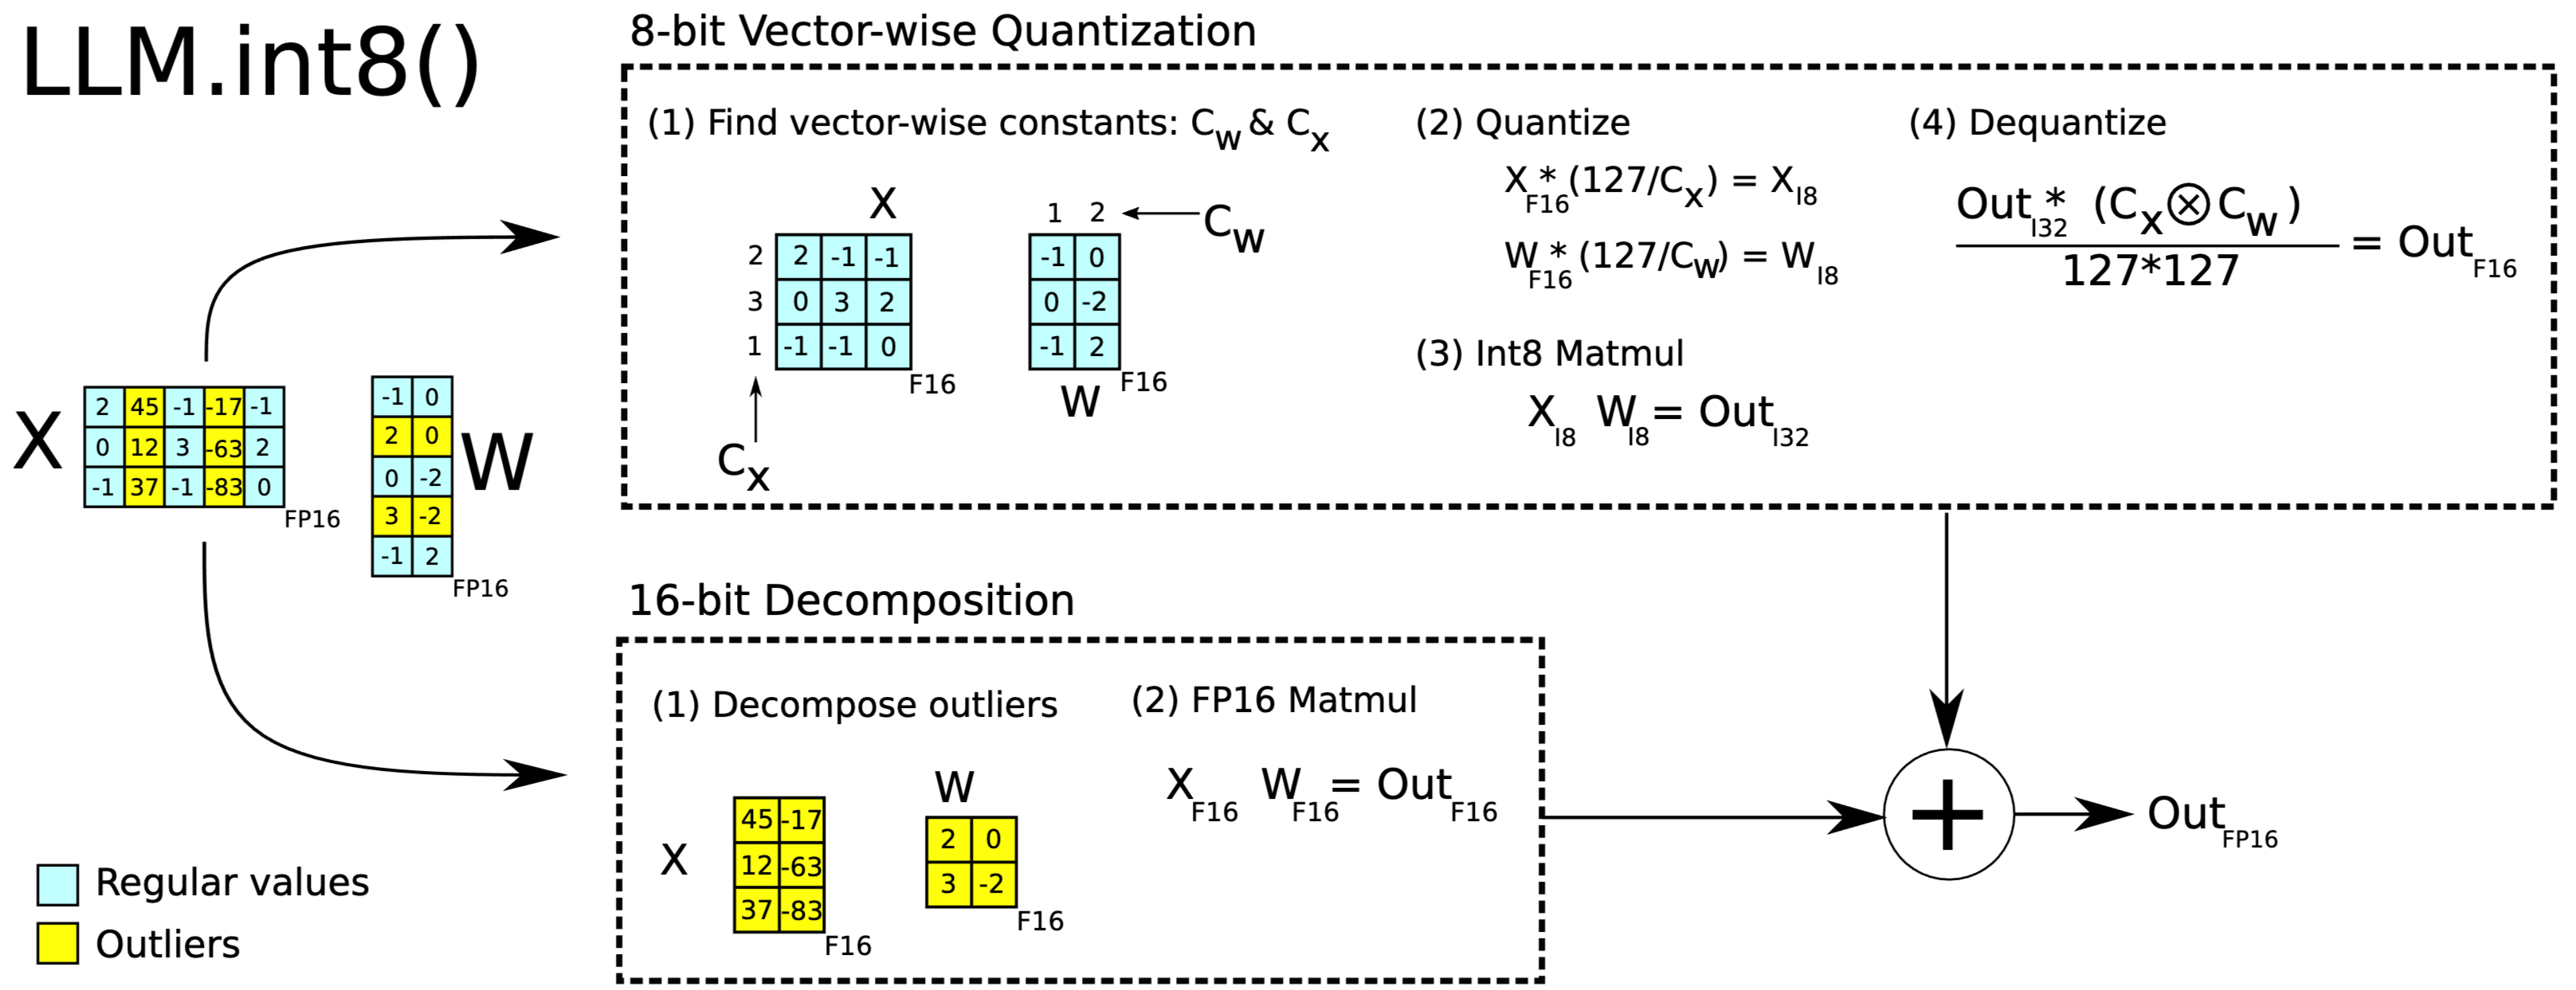
- FP16 행렬곱을 INT8 행렬곱과 FP16 행렬곱으로 분리하여 계산합니다.
- 99%의 입력들은 INT8 행렬곱을 하며 1%의 Outlier 입력들은 FP!6 행렬곱으로 수행합니다.
import torch
X = torch.randn(3, 5)
W = torch.randn(5, 3)

outlier = [1, 3]
inlier = [0, 2, 4]

in_X = X[:, inlier]
out_X = X[:, outlier]

in_W =  W[inlier, :]
out_W = W[outlier, :]

q_X, C_x = quant_i8(in_X, dim=0)
q_W, C_w = quant_i8(in_W, dim=1)

in_i32 = q_X @ q_W
in_fp16 = in_i32 * (C_x[:, None] * C_w[None, :]) / (127 * 127)

out_fp16 = out_X @ out_W

result = in_fp16 + out_fp16
Outlier
Outlier 기준
-
값의 크기가 $ value \geq 6.0 $ 이상일 것 (값의 크기 기준 ) |X_l[:, :, :, dim]| ≥ 6.0인 경우가 있어야 합니다.
- 해당 특징 차원이 전체 시퀀스 위치의 6% 이상에서 나타날 것 (시퀀스 위치 기준)
-
X_l[:, :, ctx, dim]안에서 전체 CTX 위치 중에서값 ≥ 6인 위치 비율 ≥ 6%면 d는 아웃라이어 후보로 판단됩니다.
-
- 해당 특징 차원이 전체 레이어의 25% 이상에서 나타날 것
X_l[:, head, ctx, dim]의 아웃라이어 후보가 25% 이상 나타나면d를 아웃라이어로 간주합니다.
Outlier와 성능지표
-
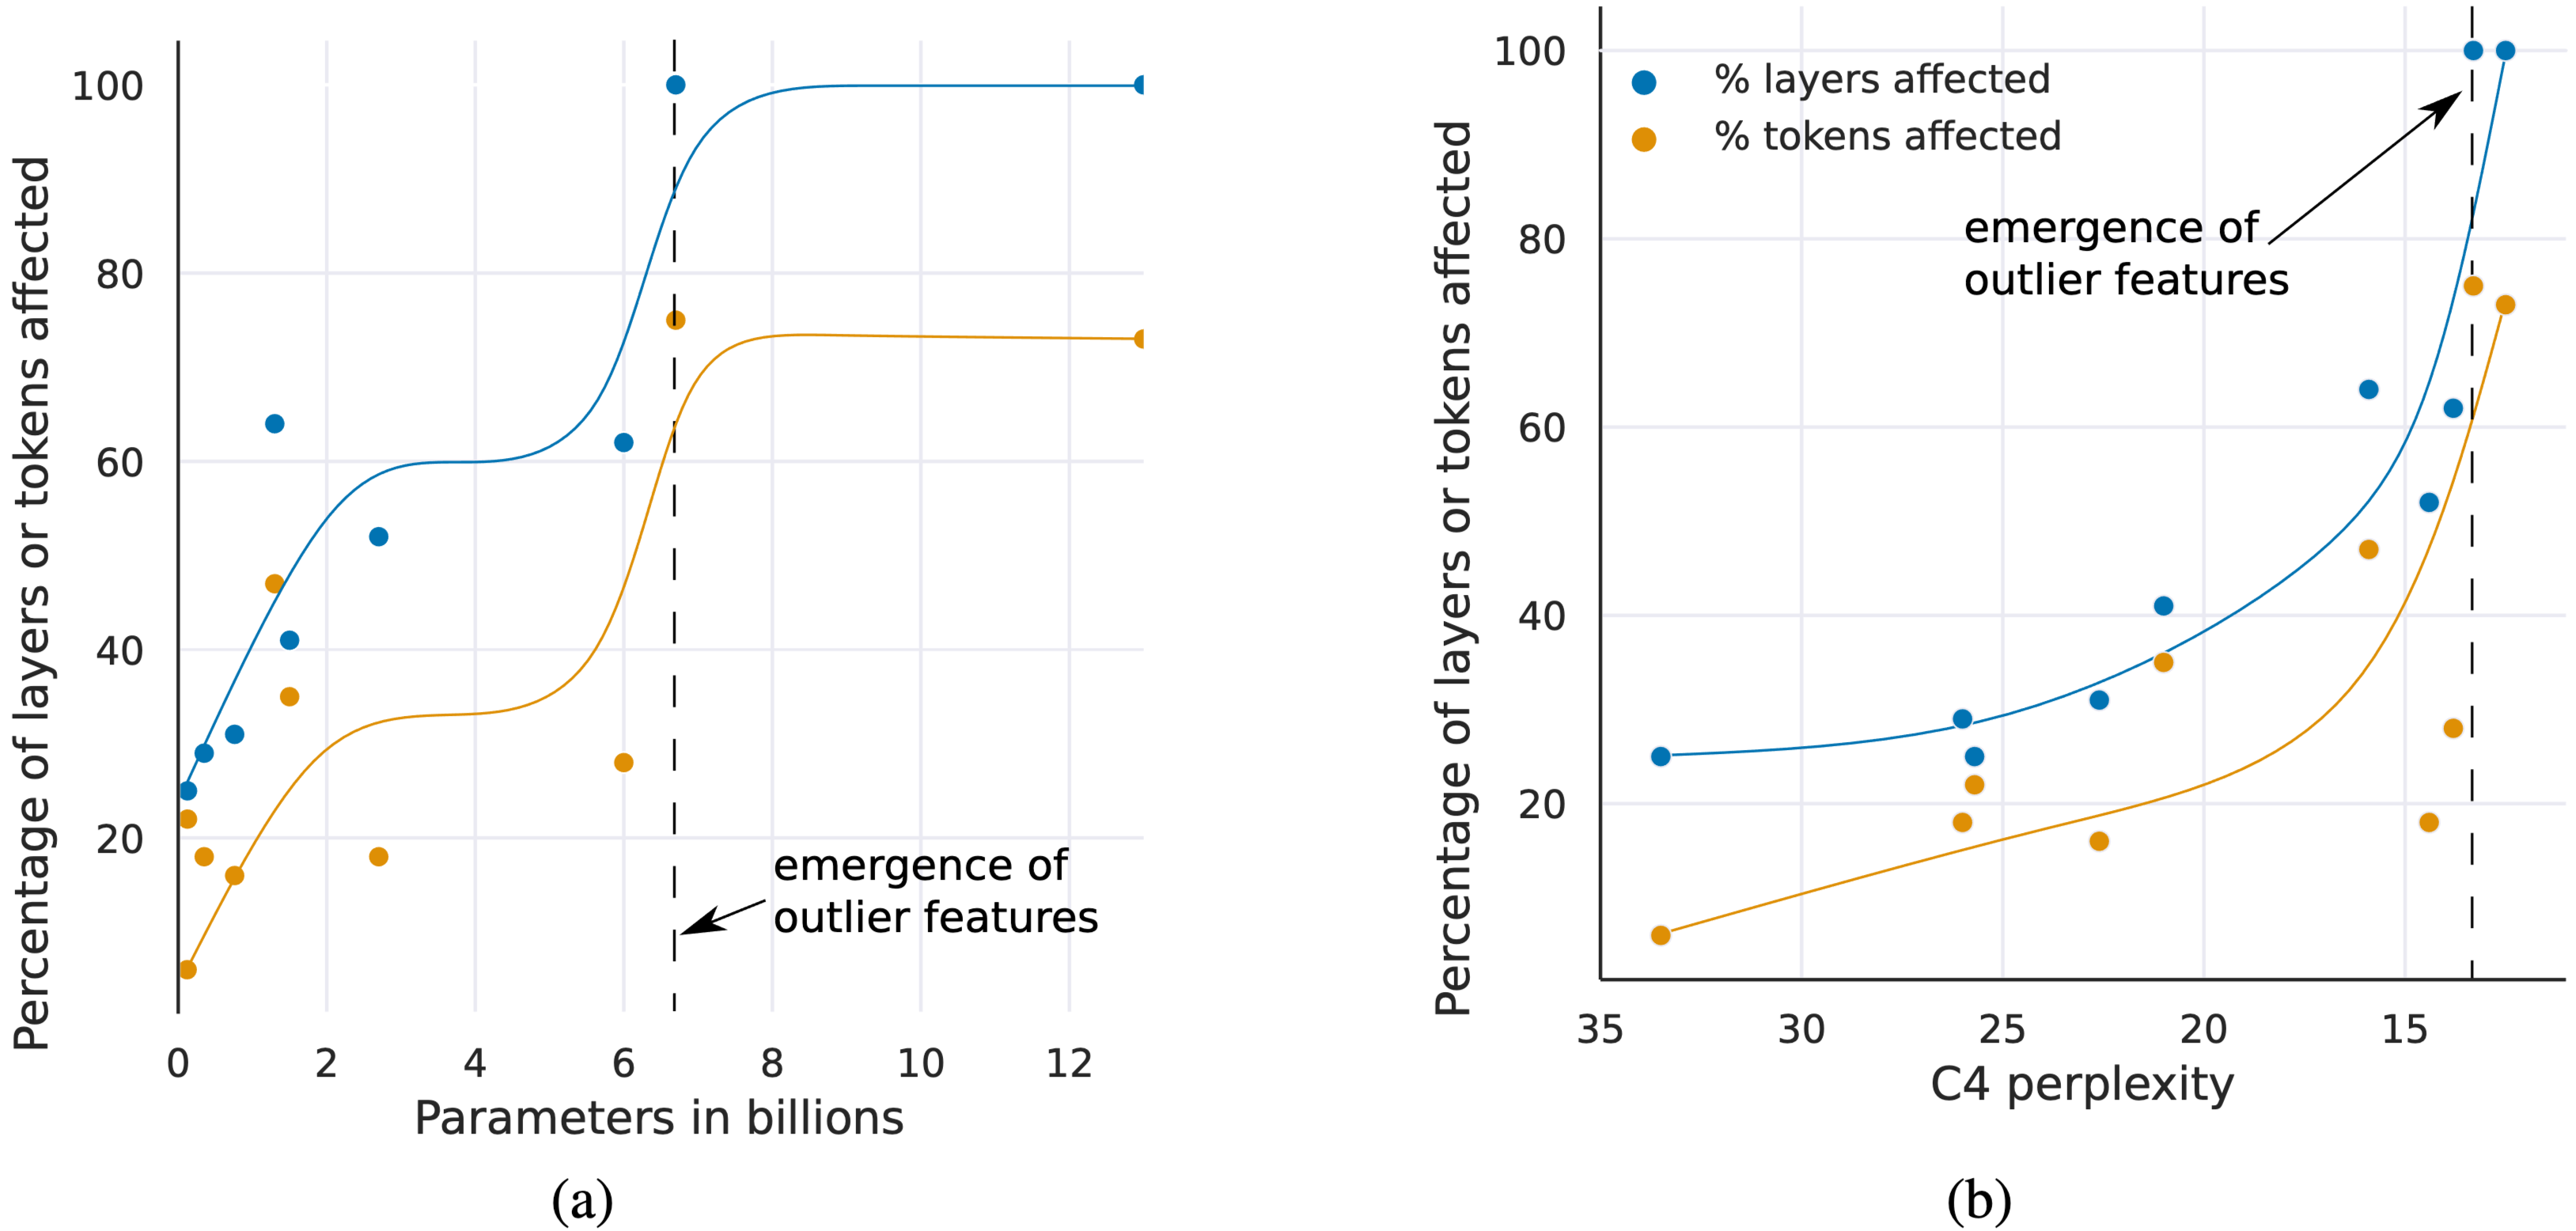
파란색: 전체 레이어 중 아웃라이어 feature가 영향을 준 비율 (%)
-
주황색: 전체 시퀀스 위치(토큰) 중 아웃라이어 feature가 영향을 준 비율 (%)
-
(a) 해석: 모델 크기가 약 6~7B쯤 되는 순간, 모든 레이어와 대부분의 토큰 위치에서 아웃라이어가 출현합니다. 이는 양자화 성능이 급격하게 나빠지는 지점과 일치합니다.
-
(b) 해석: 점진적이며 지수적으로 증가합니다. 모델이 점점 더 성능이 좋아질수록, 아웃라이어 feature가 레이어와 시퀀스 전체로 점점 더 퍼져갑니다.
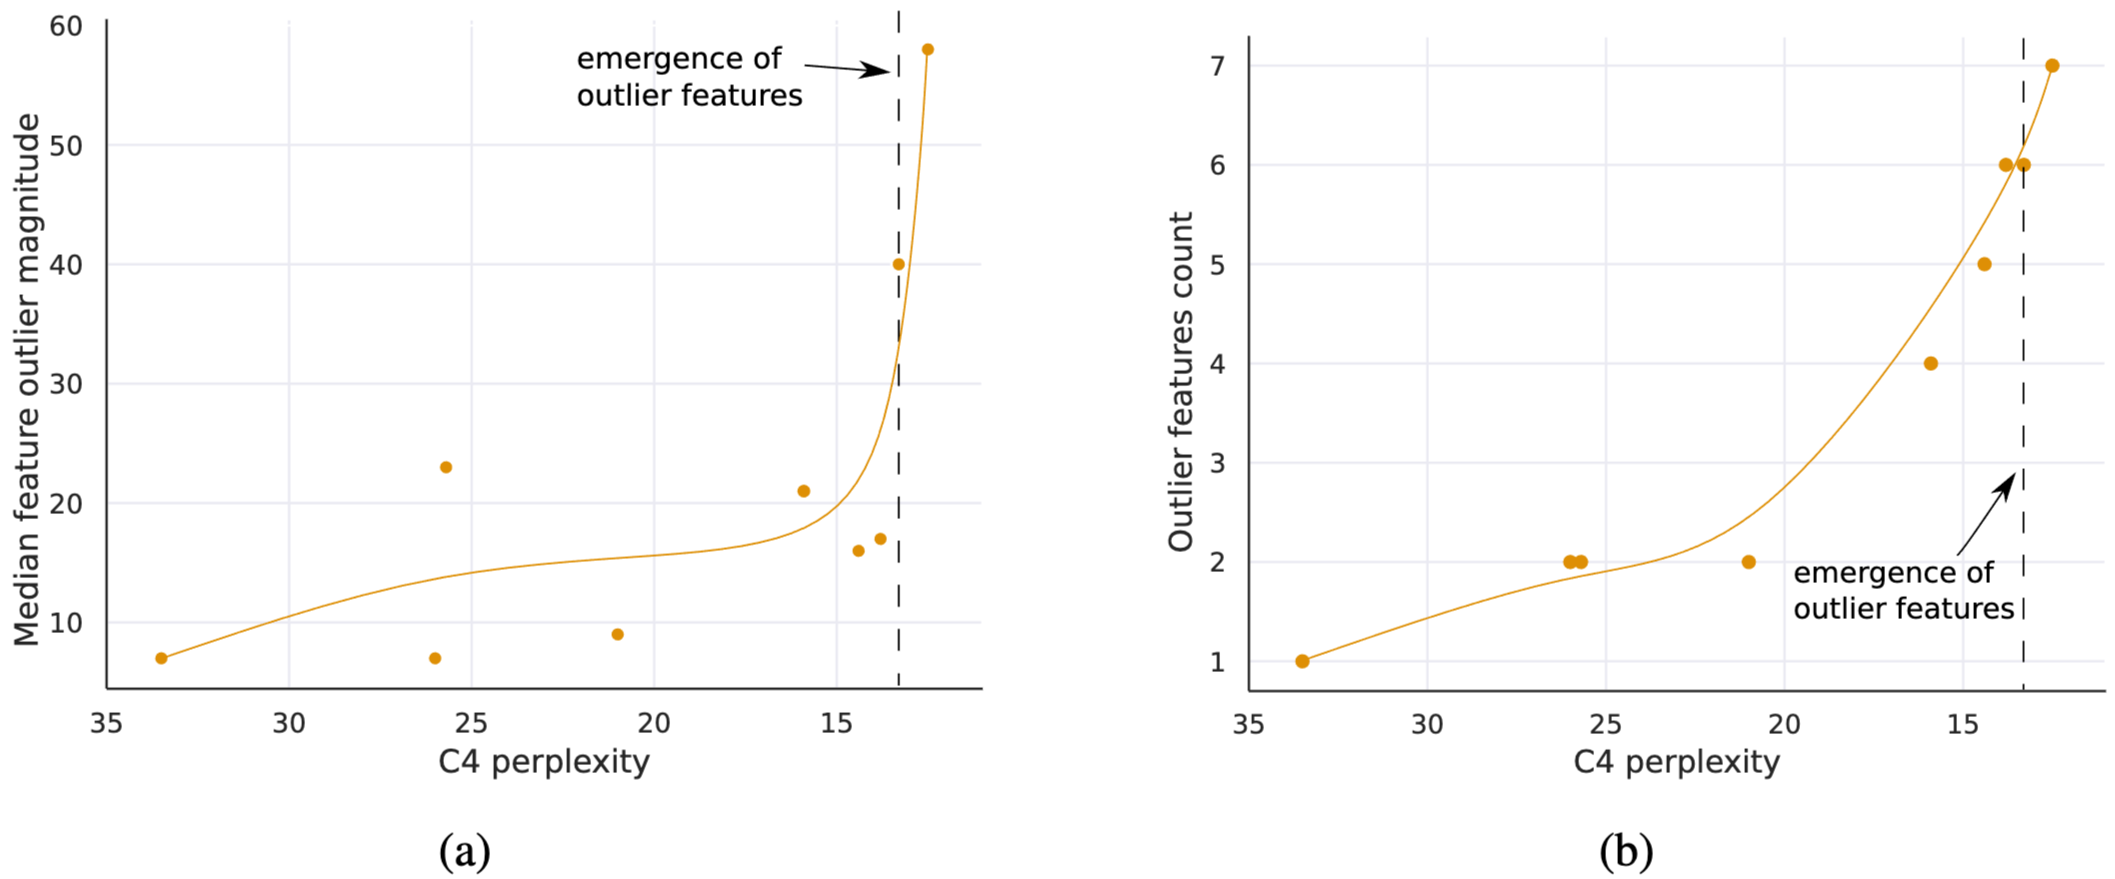
- (a) 해석: 모델 성능이 좋아질 수록 Outlier의 중간 값을 나타냅니다. 성능이 좋을 수록 Outlier의 크기가 급격하게 증가하는 것을 볼 수 있습니다. 이는 모델의 양자화를 어렵하게 만드는 주요 요인입니다.
- (b) 해석: 모델 성능이 좋아질 수록 Outlier의 빈도가 증가하는 추세를 보입니다.
Experiment
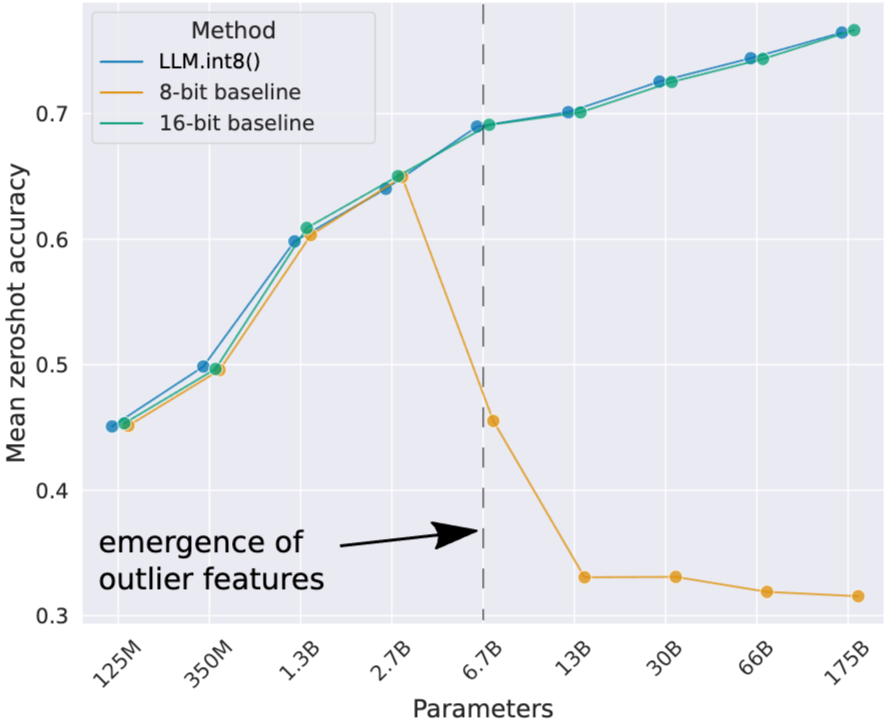
- 모델 크기가 커짐에 따라 16비트 실수 연산 기준선과 제안하는 LLM.int8()은 비슷한 성능을 유지합니다.
- 반면, 8비트 양자화 기준선은 6.7B 파라미터 규모에서 outlier features가 나타나면서 성능이 크게 저하됩니다.