[논문 리뷰] FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision
“FlashAttention-3” 논문은 Jay Shah, Ganesh Bikshandi, Ying Zhang, Vijay Thakkar, Pradeep Ramani, 그리고 Tri Dao 등이 공동으로 제안한 연구로, 트랜스포머 모델에서 긴 시퀀스를 처리할 때 어텐션 메커니즘의 메모리 및 연산 효율성을 극대화하고자 개발되었습니다. 이 논문은 2024년 7월 arXiv에 처음 공개되었으며, 이후 NeurIPS 2024 메인 컨퍼런스 트랙에 정식 채택되어 발표되었습니다.
아이디어
- Producer-Consumer asynchronoy
- 데이터의 생산자(Producer) 워프와 소비자(Consumer) 워프를 분리 배치하여, 메모리 이동과 연산을 병렬로 중첩합니다.
- Hiding softmax under asynchromous block-wise GEMMs
- Softmax에서 수행되는 비교적 처리량이 낮은 연산(floating point multiple-add, exponential)을 비동기 WGMMA 명령어로 처리되는 GEMM 연산과 겹치도록 합니다. 이를 통해 Softmax의 연산 시간을 GEMM 연산 시간으로 숨기고, 전체 처리 효율을 극대화합니다.
- (예시) 한 블록의 점수 행렬에 대한 Softmax가 실행되는 동안 비동기 프로세스에서는 곧 바로 그다음 블록에 대한 WGMMA 연산을 수행합니다.
- Hardware-accelerated low-precision GEMM
- Tensor Core의 FP8 연산 지원을 통해 기존 BF16/FP16 대시 연산 처리량(TFLOPs/s)을 두 배로 끌어올립니다.
GPU 하드웨어 특성
아키텍처
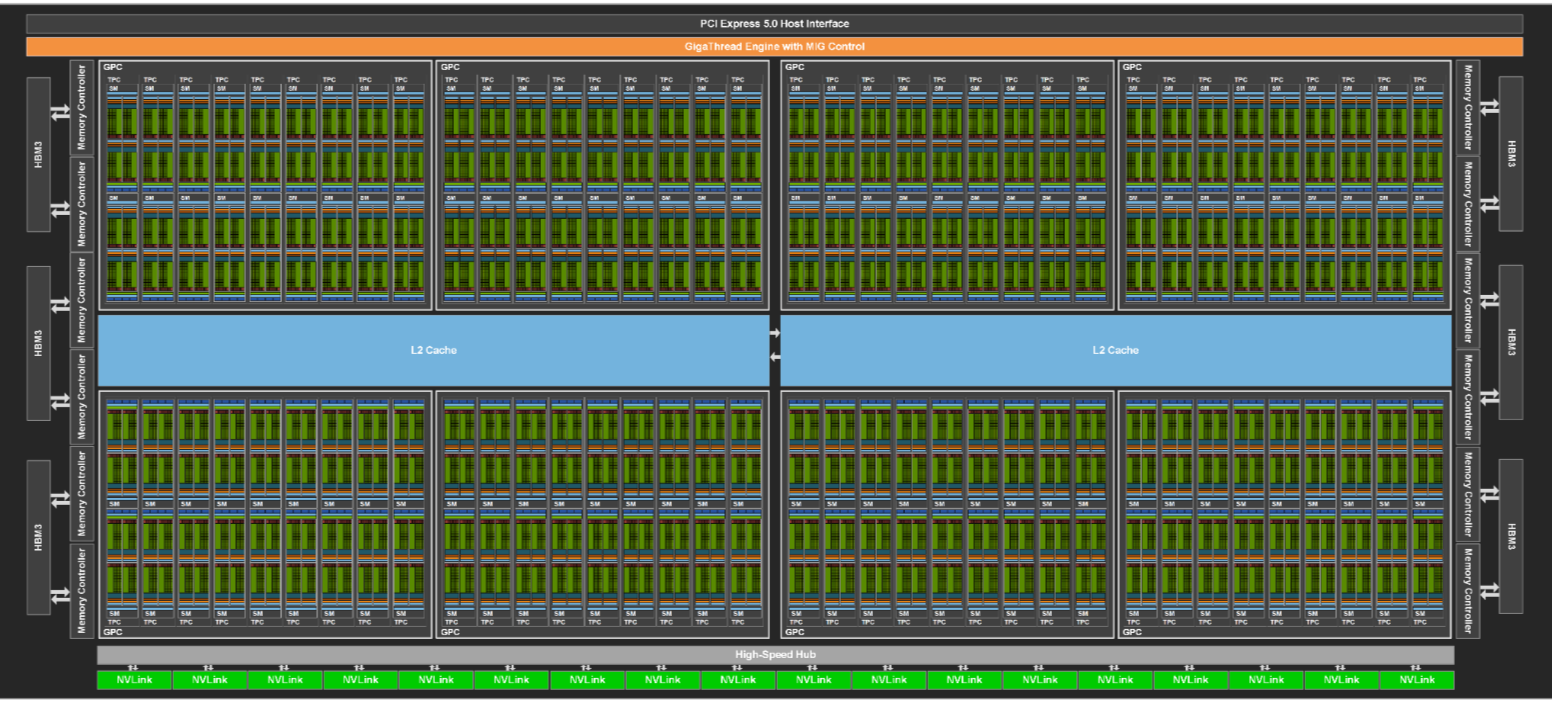
SM 내부 모습
<img src="../../images/2025-04-07-flash_attention_3/image-20250407124735334.png" style"width:80%;">
대역폭
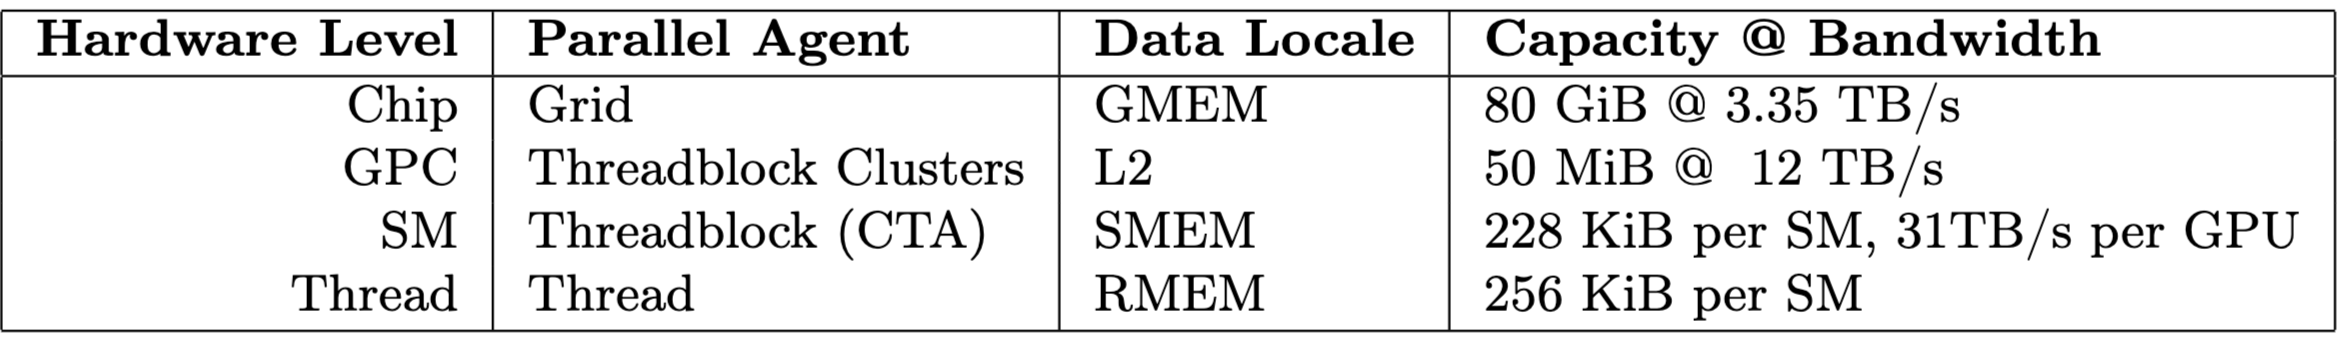
Thread hierarchy
- Thread (스레드)
- GPU에서 명령을 실제로 실행하는 가장 작은 단위.
- 각각의 스레드는 자신만의 레지스터 세트를 갖고, 한 개의 명령을 수행합니다.
- Warp (워프)
- 32개의 스레드가 묶여서 한꺼번에 같은 명령어를 실행하는 최소 스케줄링 단위.
- “SIMT”(Single Instruction, Multiple Threads) 모델로, 한 워프 내 모든 스레드는 동시·동일한 명령어를 수행합니다.
- Warp Group (워프그룹)
- 연속된 4개의 워프(총 128스레드)를 하나의 그룹으로 묶은 개념.
- Hopper 아키텍처에서 TMA 복사나 비동기 Tensor Core 연산(mma_async) 시, 워프를 이 단위로 묶어 역할(Producer vs Consumer)을 나눌 때 사용합니다.
- Thread Block / CTA (스레드 블록, Cooperative Thread Array)
- 여러 워프(최대 32 워프, 1024스레드)로 구성된 실행 단위.
- 같은 블록 내 스레드들은 shared memory를 공유하고,
__syncthreads()로 동기화할 수 있습니다. - 하나의 CTA가 곧 하나의 작업 단위(예: 하나의 Q‑block 처리)를 담당합니다.
- ThreadBlock Cluster(스레드블록 클러스터, Hopper 전용)
- Hopper 아키텍처에서 CTA들을 물리적·논리적으로 묶어 TMA와 Tensor Core의 비동기 파이프라이닝을 최적화하기 위해 사용되는 단위
- 같은 클러스터에 속한 CTA들은 TMA 버퍼와 Tensor Core 파이프라인을 협력적으로 공유·스케줄링합니다.
- Grid (그리드)
- 커널 실행 시 한 번에 런치되는 모든 CTA(스레드블록)의 집합.
- 셀프 어텐션에서는 Batch $\times$ Head $\times$ Row 블록 수 만큼 CTA를 띄우고, 배치 행렬 곱에서는 Batch $\times$ M $\times$ N 블록 수 만큼 CTA를 띄운다.